用于实时声源定位的被动式声学传感
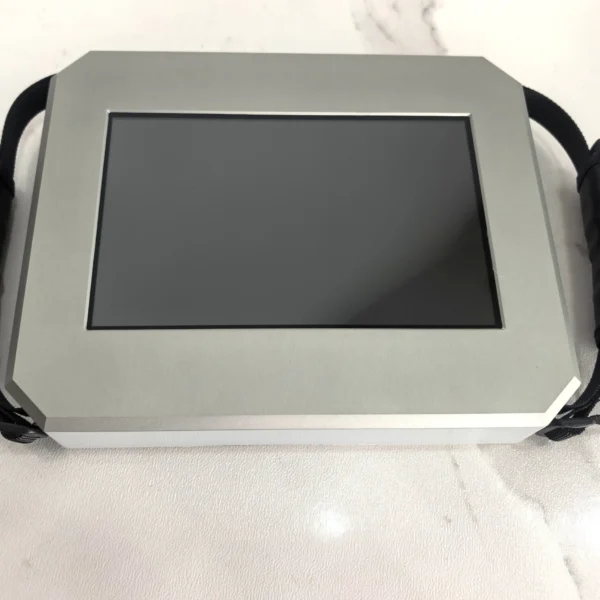
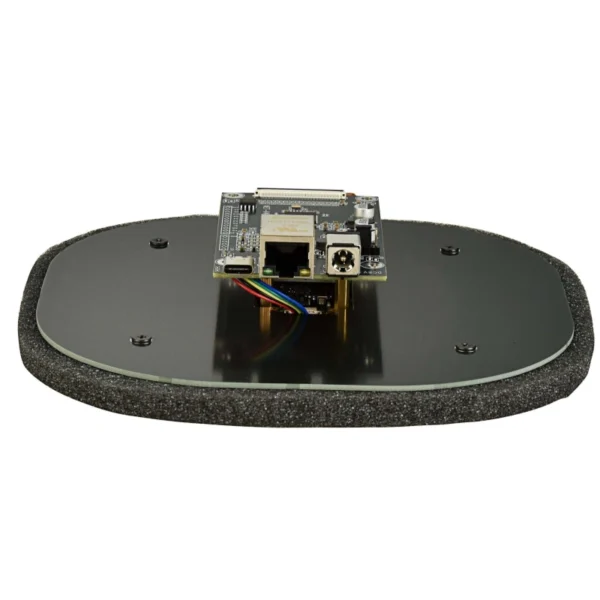
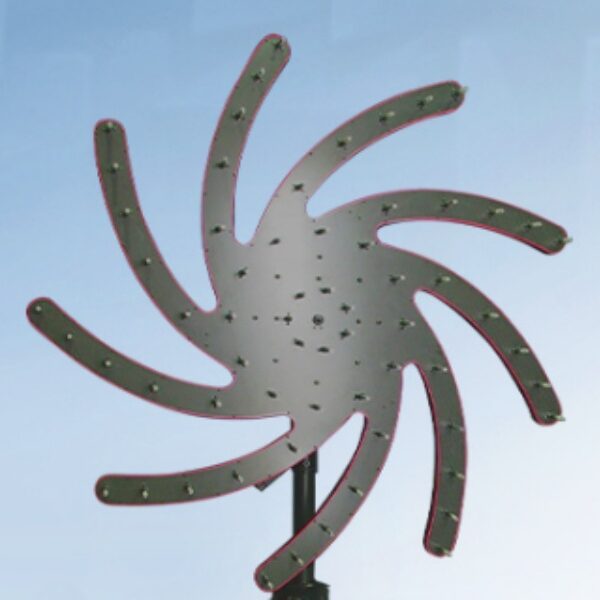
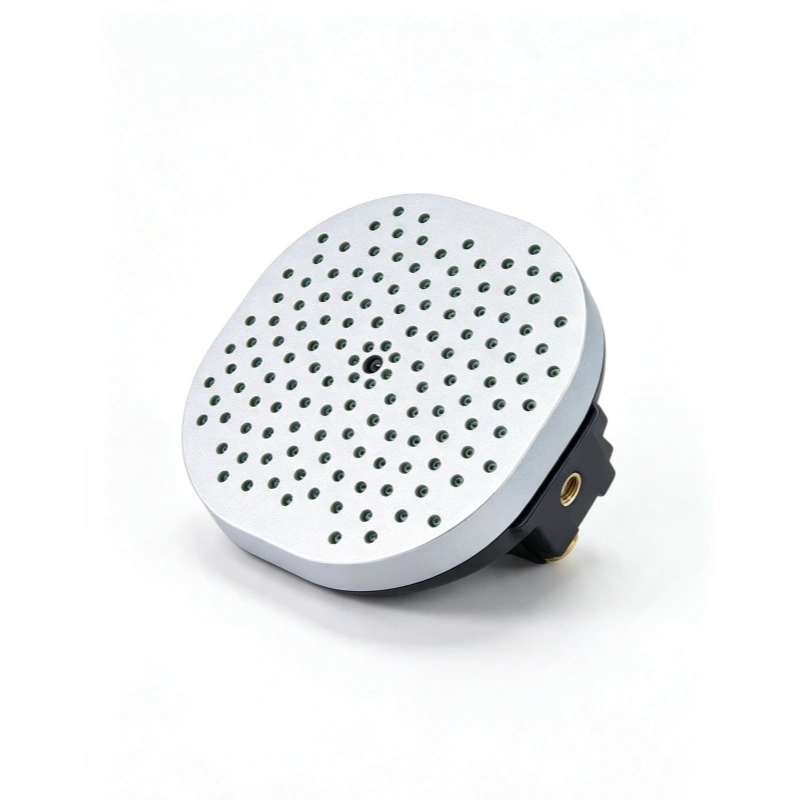
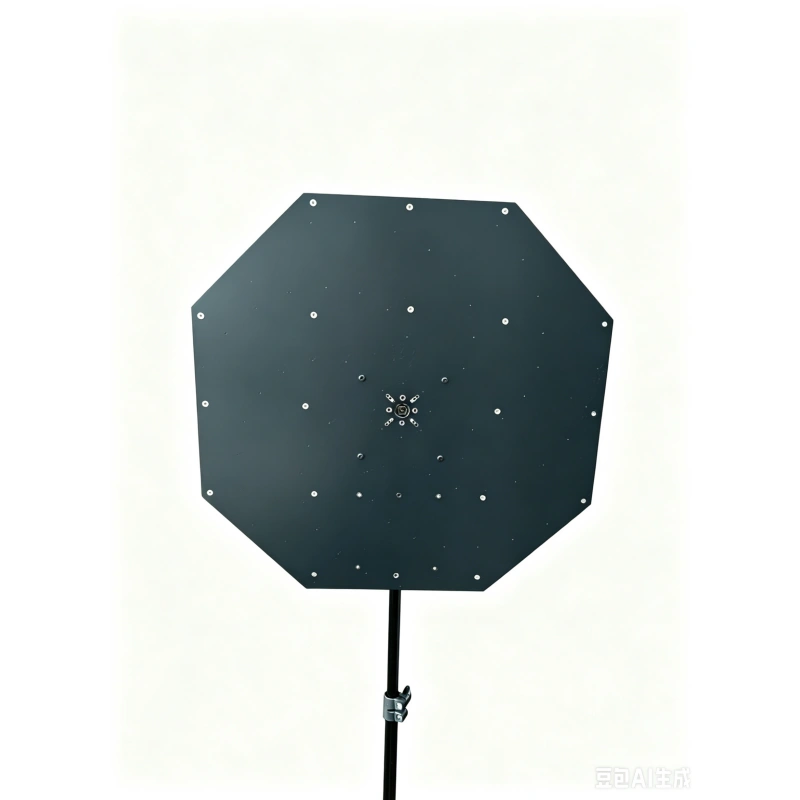
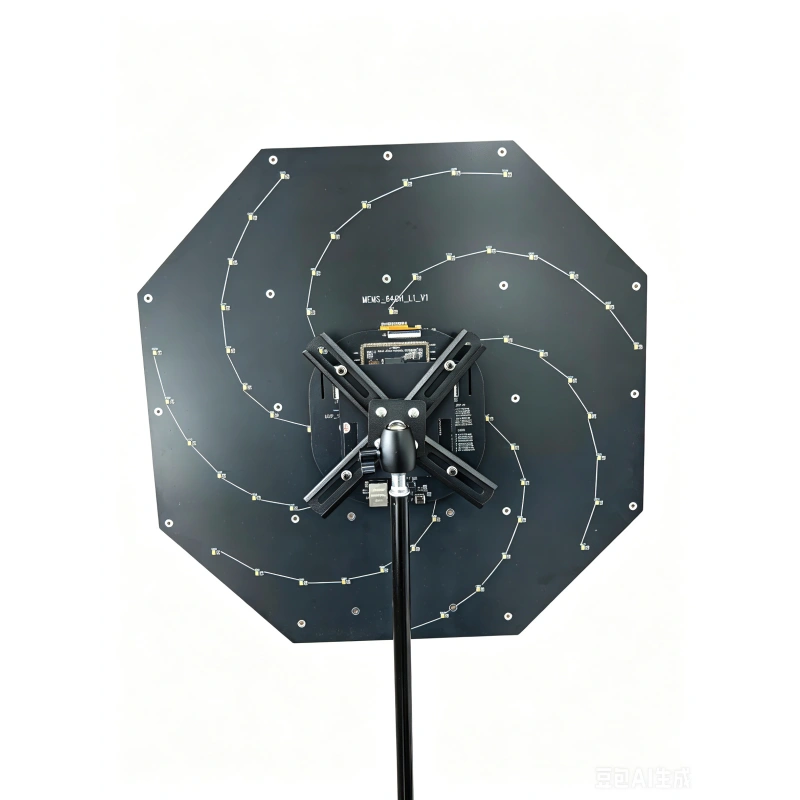
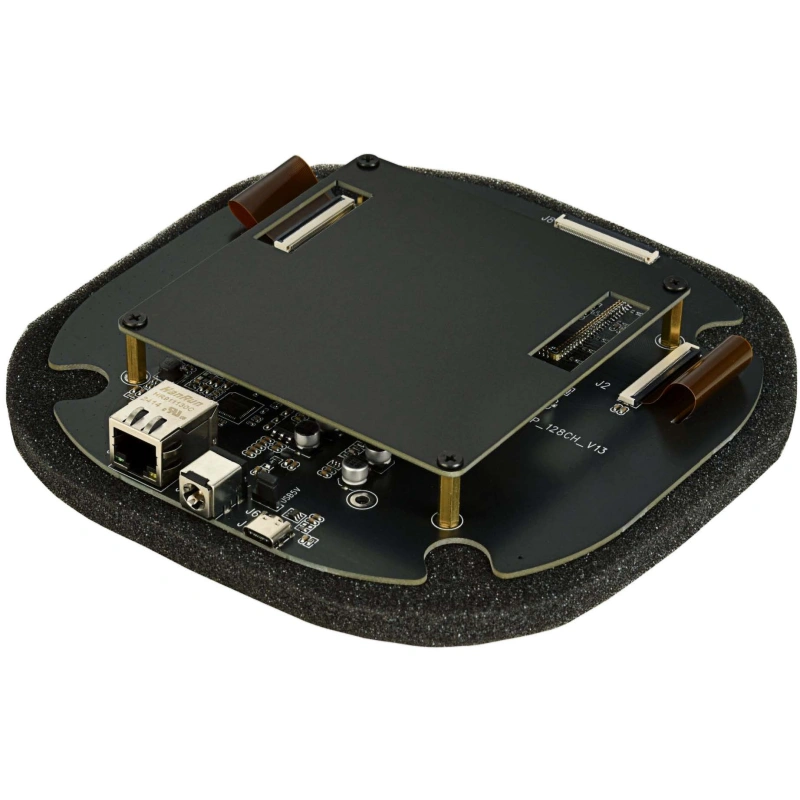
SISTC的 SV-SSL128/64 是一个高密度 MEMS 麦克风阵列系统 专为实时被动声学感知和声源定位而开发。.
该系统将128个或64个同步工作的MEMS麦克风集成到一个紧凑的阵列中,其尺寸约为 450 毫米口径. 通过分析不同麦克风接收到的声信号之间的时间差,该系统可以估算多个声源的方向和位置。.
核心处理基于 时间差 (TDOA) 与 波束成形, ,从而使系统能够将声学信号转换为空间信息。.
其结果远不止是一款传统的麦克风阵列。SV-SSL128/64 为需要以下功能的应用提供了完整的声学传感基础: 声音检测、定位、定向拾音、跟踪以及基于人工智能的声学识别.
无需信号传输的被动检测
SV-SSL128/64 的一个关键特点是其 被动声学传感架构.
该系统无需发射射频、超声波或其他主动探测信号。相反,它会持续接收并分析来自周围环境的自然产生的声学信号。.
这种无源工作原理具有以下几个优点:
- 无射频或超声波传输
- 低功耗
- 降低电磁辐射
- 低调的持续监测
- 适用于分布式传感器部署
- 兼容太阳能供电系统
- 适用于更倾向于采用被动式传感的环境
因此,该系统可作为声学感知层,与摄像头、雷达和人工智能感知系统等其他技术协同工作。.
128通道和64通道配置
SV-SSL 平台提供两种通道配置:
128通道版
128通道配置为需要更高空间分辨率和先进多声源声学分析的应用提供了高密度的空间采样架构。.
它特别适合:
- 高分辨率声学定位
- 多源追踪
- 高级波束成形
- 声成像
- AI声音识别
- 研究与算法开发
- 大规模分布式传感系统
64通道版本
64通道配置在空间分辨率、系统复杂度、功耗和部署成本之间实现了平衡。.
适用于:
- 声源定位
- 定向声音采集
- 工业声学监测
- 周界监控
- 活动安保
- AI声学传感
- 声学算法开发
这两种配置均采用同步MEMS麦克风采样,以提供一致的多通道声学数据基础。.
基于TDOA的声音源定位
SV-SSL128/64 采用 时间差 (TDOA) 一种用于估算入射声信号方向的技术。.
当声源产生声波时,由于声源位置和传播路径的不同,声波到达每个麦克风的时间会略有差异。.
通过比较各麦克风通道之间的相对到达时间,系统可以计算出声源的方向。.
本地化流程可表示为:
同步MEMS采集 → TDOA估算 → 波束成形 → 空间定位 → 多源跟踪 → AI识别
该架构使该平台能够将原始声学信息转换为可操作的空间数据。.
波束成形与定向拾音
除了TDOA定位外,还可以利用波束成形技术将信号在空间上聚焦到特定方向。.
这使得系统能够:
- 增强来自选定方向的声学信号
- 抑制不需要的离轴声
- 生成定向音频流
- 分离多个声源
- 提高下游人工智能算法的输入质量
- 为声学成像提供空间音频信息
该系统可以输出 多方向音频通道, ,从而允许外部软件或人工智能算法对各个声源进行进一步处理和分类。.
广阔的空间覆盖范围
单个 SV-SSL 阵列可提供广泛的空间声学覆盖范围:
- 方位角: 最高120°
- Elevation: 最高90°
- 检测距离: 在安静的环境中,最远可达1,000米
- 检测距离: 在城市环境中约为 200 米
实际探测距离取决于目标的声学输出、背景噪声、大气条件、安装环境以及目标与阵列之间的几何关系。.
对于较大的监测区域,可以部署多个阵列作为 分布式声学传感网络.
多阵列协同定位
多个 SV-SSL 阵列可协同工作,以扩大监控范围并提升空间感知能力。.
分布式部署可以整合来自多个声学节点的定位信息,以支持:
- 大范围声学监测
- 跨阵列声源定位
- 多点声源跟踪
- 大范围声学监听
- 分布式工业监控
- 多区域环境监测
这种架构使系统集成商能够构建可扩展的声学传感网络,而不是依赖于单个传感节点。.
基于人工智能的声学识别与分类
本地化提供了关于 声音传来的方向. 人工智能语音识别可以提供有关……的更多信息 检测到的是什么类型的声音.
因此,SV-SSL128/64 可与用于声音分类和事件识别的 AI 模型集成。.
潜在的人工智能处理功能包括:
- 声音事件检测
- 声学模式识别
- 目标声音分类
- 异常声音检测
- 多源分类
- 声学事件验证
- 历史声学模式分析
这形成了一条完整的处理链:
检测 → 定位 → 跟踪 → 识别 → 分类 → 验证
AI 处理既可以在外部边缘计算平台上实现,也可以集成到更大的传感器融合架构中。.
适用于分布式部署的低功耗特性
该系统的功耗约为 4 W, ,因此适用于电源供应受限的应用场景。.
该低功耗架构支持:
- 太阳能发电设施
- 远程监测站点
- 分布式声学传感器网络
- 长期连续运行
- 边缘声学传感
- 基础设施监控
对于偏远地区,SV-SSL128/64 可与太阳能供电、电池储能以及无线或有线网络相结合,构建自主声学监测节点。.
声学成像与多源监测
最高可达 16个同时工作的目标源 以及最高达 25 FPS, ,该系统能够提供关于多个声学事件的实时空间信息。.
这使得该平台适用于可能同时存在多个声源的环境。.
该系统可以输出:
- 方位角
- 海拔
- 定向音频
- 多个目标位置
- 声学成像信息
这些输出结果随后可通过 PC 应用程序、边缘计算系统或定制的可视化平台进行显示。.
工业声学异常监测
用于声源定位的同一项技术也可应用于工业声学诊断。.
机器和工业设备在正常运行期间会产生具有特征性的声学特征。.
这些特征的变化可能表明存在异常运行状况,例如:
- 机械摩擦
- 漏气
- 燃气泄漏
- 轴承异常
- 瓣膜异常
- 旋转机械的异常情况
- 意外的撞击或碰撞声
- 设备异常噪音
SV-SSL128/64 既可提供 空间信息和方向性音频, ,不仅能帮助维护系统识别是否发生了异常声学事件,还能确定其来源位置。.
典型应用
周边及场地安保
连续被动声学监测可为大型场地和保护区提供额外的监测层。.
该系统能够检测、定位和分类声学事件,并向中央监控平台提供方向信息。.
关键基础设施监测
该平台可部署在大型设施和基础设施周围,以提供持续的声学监测,并检测异常声学事件。.
活动安保
大型公共或私人活动可利用分布式声学传感节点,对多个区域内的声学事件进行监测。.
工业异常检测
工厂、生产线和工业设施可利用声学定位技术,识别设备发出的异常声响并确定其具体位置。.
环境声学监测
该系统还可用于环境声源的长期监测和空间分析。.
声学人工智能开发
凭借高密度MEMS麦克风通道和空间声学信息,该平台为开发定制化AI声学感知系统提供了硬件基础。.
主要技术规格
| 参数 | 规格 |
|---|---|
| 麦克风通道 | 128通道 / 64通道 |
| 阵列孔径 | 约 450 毫米 |
| 本地化技术 | TDOA + 波束成形 |
| 声学传感 | 被动语态 |
| 频率范围 | 20 Hz – 8 kHz |
| 声压级 | 25 dB SPL – 120 dB SPL |
| 方位角覆盖范围 | 最高120° |
| 高程覆盖范围 | 最高90° |
| 最大探测距离 | 在安静的环境中,最远可达 1,000 米 |
| 典型城市行驶里程 | 最长约200米 |
| 本地化时间 | 约 100 毫秒 |
| 声成像帧频 | 最高 25 FPS |
| 最大目标源 | 最多 16 |
| 定位精度 | 悬停目标为±2.0° |
| 多阵列协作 | 支持 |
| 定向音频输出 | 支持 |
| 输出信息 | 方位角 / 仰角 / 定向音频 |
| 耗电量 | 约4瓦 |
| 电源选项 | 直流电/太阳能供电部署 |
| 人工智能集成 | 声音识别、分类与验证 |
| 网络架构 | 适用于分布式部署 |
实际性能取决于目标声学特性、环境噪声、安装几何形状、大气条件和系统配置。.
为什么选择 SV-SSL128/64?
高密度MEMS阵列
多达128个同步工作的MEMS麦克风,为先进的声学定位和波束成形技术提供了高密度的空间采样平台。.
被动声学探测
该系统监听自然产生的声学信号,而不发射主动探测信号。.
实时定位
基于TDOA的处理可实现快速的方向定位,其典型定位时间约为100毫秒。.
3D声学感知
该系统同时提供方位角和仰角信息,从而能够实现三维声学定位。.
多源支持能力
该系统能够处理和追踪多个声源,在条件适宜的情况下,最多可同时处理16个目标。.
低功耗
约4 W的功耗使得远程、分布式及太阳能供电的部署成为可能。.
支持人工智能的架构
声学定位层可与人工智能声音识别和分类技术相结合,构建智能声学感知系统。.
可扩展的部署
可以将多个阵列组合起来,构建覆盖更大区域的分布式声学传感网络。.
从麦克风阵列到声学智能
SV-SSL128/64 的设计不仅仅是一个麦克风阵列,而是一个 声学感知平台.
该平台通过整合高密度MEMS麦克风、同步采样、TDOA定位、波束成形、定向音频以及基于人工智能的声音识别技术,为下一代智能声学系统提供了所需的核心感知层。.
对于系统集成商、研究人员以及OEM/ODM客户,SISTC还能进一步提供定制化麦克风配置、阵列几何结构、声学算法、边缘计算集成以及多传感器系统开发方面的支持。.
SISTC — MEMS 麦克风技术与智能声学传感解决方案
申请产品演示
视频演示和 API 访问
想看看 SV-SSL128/64 是如何生成实时声学波束成形图的吗?
[观看现场产品视频演示] (https://youtu.be/KPxs6mSC974)
[申请 SDK 和 API 文档] 联系我们的工程团队 sureny@sistc.com 以评估我们的多声道音频采集 API 和示例演示源代码。